RepoWrapped: um Spotify Wrapped para um repo do GitHub, e a API que brigou comigo
Uma ideia de fim de semana — uma página de stats compartilhável e um badge de README para qualquer repo e contributor do GitHub — virou uma briga com a API de stats do GitHub: 202 que nunca se resolvem, um muro no top 100 e um lookup do primeiro commit que você precisa arrancar de um header.

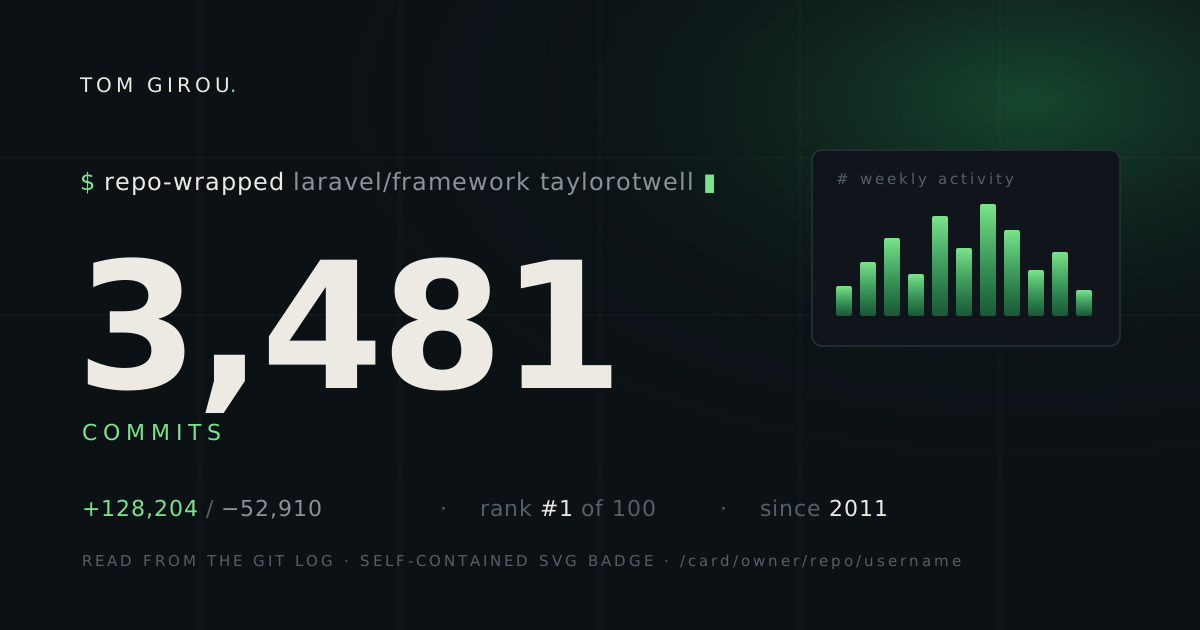
Todo mês de dezembro, o Spotify te entrega uma pequena retrospectiva do ano e metade do seu feed vira print disso. Funciona porque os números sempre estiveram lá — você só nunca tinha visto eles enquadrados como uma história sobre você. Eu queria isso para um repo do GitHub. Aponte para owner/repo, escolha um contributor e receba uma página dizendo: aqui está quantos commits você emplacou, aqui está a sua posição no ranking, aqui está a semana em que você ficou insano. E depois deixe você colocar um badge SVG no seu README, para ele ficar ao lado do status do build.
O pitch era só isso. Um fim de semana, talvez. Chamei de RepoWrapped, e a parte de front-end realmente levou um fim de semana. O resto do tempo foi numa briga que eu não vi chegando: conseguir tirar os números do GitHub, para começo de conversa.
Isso é uma mudança de ritmo em relação aos posts sobre segurança com IA que venho escrevendo ultimamente — nada de modelos aqui, só uma pequena app Laravel e uma API que não quer te dizer o que você está perguntando. É o tipo mais honesto de história de side project, aquela em que a ideia divertida é um erro de arredondamento e o trabalho de verdade está num lugar que você não esperava.
A ideia é trivial. Os dados não.
Por que puxar stats de um repo é mais difícil do que parece? “Pegar as stats de commits de um repo” soa como um endpoint. Não é um endpoint, e os que você precisa se comportam de jeitos que só fazem sentido depois que você já se queimou com eles.
Eis o que eu queria por contributor: total de commits, linhas adicionadas e removidas, um sparkline de atividade semanal, a data do primeiro commit e a posição no ranking do repo. Quatro desses cinco vêm de um único endpoint do GitHub — /stats/contributors. É nesse endpoint que se passa a maior parte desta história, porque ele tem duas armadilhas, e eu caí nas duas.
Armadilha um: o 202 que significa “volte mais tarde”
O que fazer quando o GitHub retorna um 202 sem dados? Na primeira vez que você chama /stats/contributors num repo que o GitHub não processou recentemente, você não recebe dados. Você recebe um 202 Accepted e um body vazio. O GitHub está te dizendo: comecei a calcular isso, pergunte de novo daqui a pouco.
Beleza. Então você faz retry. Mas “daqui a pouco” não é um número, e para um repo grande pode demorar. Um loop de retry ingênuo ou desiste cedo demais num repo lento ou martela um repo rápido. Então o fetch faz backoff — 1, 2, 4, 8, 16 segundos, cinco tentativas — e a maioria dos repos se resolve dentro dessa janela.
A maioria. Não todos. E essa é a parte que me custou uma segunda passada para acertar: uma request web síncrona não pode ficar parada esperando 30 segundos o GitHub terminar um cálculo. O navegador do visitante desiste e, mesmo que não desistisse, você está mantendo um worker PHP refém por um job que não tem nada a ver com a resposta.
Então, quando o backoff se esgota e o GitHub ainda está retornando 202, eu paro de esperar na request e passo o problema para uma queue. Um job RetryContributorStats é disparado (5 tentativas, backoff de 30 segundos), a página retorna na hora com os dados parciais que eu tiver — marcados com partial: true para que a UI possa dizer “ainda calculando” com honestidade — e quando o job finalmente traz os números reais, ele os mescla de volta no registro armazenado. O visitante que pediu nunca vê a espera. Quem carrega a página um minuto depois vê o resultado pronto.
A lição não é sutil, mas é fácil de pular quando você está indo rápido: qualquer cálculo externo que possa levar mais tempo que o carregamento de uma página pertence a uma queue, não ao controller. O 202 é o GitHub te avisando disso educadamente, de antemão. Eu só não escutei da primeira vez.
Armadilha dois: o muro do top 100
O que acontece quando o seu contributor está fora do top 100? A segunda armadilha é mais silenciosa, porque não dá erro. /stats/contributors retorna os 100 maiores contributors por número de commits. Se a pessoa que você está “embrulhando” é o contributor 101, o endpoint retorna uma resposta limpa e bem-sucedida — e ela simplesmente não está lá. Nenhuma flag, nenhum aviso. Seu código parece funcionar, até que alguém testa em laravel/framework com um contributor intermediário e recebe uma página cheia de zeros.
Não existe um parâmetro “me dá o contributor 143”. Então o fallback é fazer na mão o que o endpoint de stats teria feito por você: paginar os commits desse usuário no repo (?author=username), abrir cada um e somar as adições e remoções a partir do diff de cada commit. É um loop N+1 e eu sei disso — uma request para listar, uma por commit para pegar a contagem de linhas — então ele é limitado a 100 commits. Não é perfeito. Mas “mais ou menos certo para a cauda longa” é melhor que “zero com toda a confiança”, e a alternativa era fingir que o contributor 101 não existe.
Deixei um comentário nesse método que diz só // N+1 by design. Alguns dos melhores comentários são os que impedem o você do futuro de “consertar” com toda a esperteza algo que foi um trade-off deliberado.
O truque do primeiro commit
Como encontrar o primeiro commit de alguém sem um endpoint para isso? O quinto número — a data do primeiro commit de alguém — não tem endpoint nenhum. A abordagem óbvia é paginar o histórico de commits até o fim, o que num repo antigo dá um monte de requests só para responder “qual é o mais velho”.
O endpoint de commits do GitHub é paginado, e respostas paginadas trazem um header Link com rel="first", rel="prev", rel="next" e — o útil — rel="last". Então: peça a lista de commits com per_page=1, leia a URL rel="last" do header, e ela aponta direto para a última página, que é o commit mais antigo. Uma request para achar a página, uma para buscá-la. Sem percorrer o histórico.
Pareceu que eu estava me safando de alguma coisa. Mas é só ler as próprias instruções da API — os metadados de paginação estavam lá o tempo todo, eu só nunca tinha tido motivo para usar rel="last" para nada antes.
O cache, porque a API tem um orçamento
Como ficar dentro do rate limit do GitHub? O rate limit do GitHub é real e, com o fan-out daquele fallback do top 100, mais próximo do que você imagina. Então nada é recalculado se não precisar. Os resultados vivem em duas camadas: Redis com TTL de 1 hora para o caminho rápido, e Postgres por 24 horas como cópia durável. Uma request checa o Redis, depois o Postgres, e só um miss de verdade dispara o job de cálculo e deixa o visitante numa página de loading que faz polling num endpoint /status até o registro ficar fresh.
Além disso, há um rate limiter token-bucket na frente do próprio client do GitHub — 10 requests por segundo, 4.500 por hora, controlados no Redis. A decisão de que tenho menos certeza mora aqui: se o Redis cair, o limiter deixa passar em vez de bloquear. Ele loga um warning e libera a request. Escolhi “a app continua funcionando e talvez eu irrite o GitHub” em vez de “o Redis soluça e o site inteiro dá 500”. Para um projeto pessoal, é a escolha certa. Para algo com um raio de impacto real, eu ia querer o padrão oposto, e acho que esse é o jeito honesto de descrever um trade-off — não “este é o pattern correto”, mas “aqui está o que eu otimizei, e aqui está quando eu inverteria”.
O badge tinha que ser um único arquivo
Por que o badge do README tem que ser um arquivo autossuficiente? A parte de que tenho mais orgulho, discretamente, é o card embutível. Você coloca isto num README:
e recebe um SVG que renderiza inline, no estilo shields.io, com ?theme= e ?hide= para controlá-lo. O porém que ninguém te avisa: o GitHub serve as imagens de README através do próprio proxy de imagens (Camo), e esse proxy busca seu SVG uma vez, a partir dos servidores dele, sem navegador e sem requests subsequentes. Qualquer coisa que seu SVG tente carregar — um avatar de avatars.githubusercontent.com, uma fonte externa, uma segunda request de qualquer tipo — simplesmente não acontece, sem aviso. Você fica com um card com um buraco de imagem quebrada onde deveria estar o rosto.
Então o card precisa ser realmente autossuficiente. É um template Blade renderizado com content type image/svg+xml, e antes de renderizar, o controller busca o avatar do contributor no servidor e o embute em base64 direto no SVG como data URI. Um arquivo, nenhuma dependência externa, nada que o proxy possa falhar em buscar. Funciona como <img src> em qualquer lugar, que é todo o propósito de um badge.
O design, rapidamente
Como a página realmente é? Vou te poupar da descrição completa, mas o visual é proposital: um readout de terminal. Fundo quase preto, IBM Plex Mono, um único acento verde-fósforo limitado a menos de cinco por cento da tela, o número grande de commits em branco puro, porque o dado é o protagonista e não precisa de enfeite. Nada de orbs com gradiente, nada de glassmorphism, nada de chrome de janela falso com bolinhas de semáforo. Parece uma CLI imprimindo suas stats, o que, para uma ferramenta voltada a quem vive no terminal, me pareceu a única escolha honesta.
As partes de que não me orgulho
O que eu ainda mudaria? Duas coisas, no espírito de não escrever um folheto de propaganda.
Tem um branch de staleness no service de cache que eu comentei e contornei por fora em vez de resolver — o controller faz a própria checagem de frescor antes, então o código comentado nunca morde, mas quem ler o service isoladamente vai ficar confuso, e “confuso mas correto” é uma dívida que ainda tenho com esse arquivo.
E tem um bug de maiúsculas/minúsculas que eu conheço e não corrigi: passo owner e repo para minúsculas antes de irem para a chave de cache, mas não o username. Então /u/laravel/framework/TaylorOtwell e /.../taylorotwell são duas entradas de cache diferentes e duas linhas diferentes no banco para a mesma pessoa. Ainda não causou problema de verdade. Com certeza vai causar no dia em que alguém compartilhar uma URL com outra capitalização. Está anotado nas notas do projeto justamente para não ser esquecido — que é o estado honesto da maioria dos side projects: uma coisa que funciona, com uma lista curta de pecados com os quais você escolheu conviver por enquanto.
Lições
O que vale levar daqui?
- A ideia nunca é o trabalho. “Spotify Wrapped para um repo” foi um fim de semana de UI. O projeto de verdade foram três peculiaridades de um único endpoint do GitHub. Quando algo parece trivial, a fonte de dados geralmente é onde a engenharia de verdade se esconde.
- Um 202 é uma instrução de design. Quando uma API te diz que precisa de tempo, essa é a sua deixa para tirar o trabalho do caminho da request e jogar numa queue — não para insistir com mais retries no controller.
- Trate o buraco silencioso, não só o erro barulhento. O muro do top 100 nunca lança exceção. As falhas que não se anunciam são as que chegam em produção parecendo sucesso.
- Autossuficiente ganha de esperto. O badge funciona em qualquer lugar porque não pede nada de quem o embute. Um arquivo, nenhum fetch, nenhuma surpresa — essa restrição o deixou robusto, não limitado.
É open source, Laravel 13 e PHP 8.3, licença MIT. Se você apontar para um repo seu e os números parecerem certos, essa correção silenciosa custou mais do que a página bonita. Geralmente é assim.