Markdown for Agents, self-hosted: um subscriber Symfony no lugar de um plano da Cloudflare
A Cloudflare converte páginas em markdown para agentes de IA via Accept: text/markdown — nos planos pagos. O mesmo contrato HTTP cabe num event subscriber Symfony de 144 linhas. Minha homepage foi de 59 KB de HTML para 7,7 KB de markdown, na mesma URL.

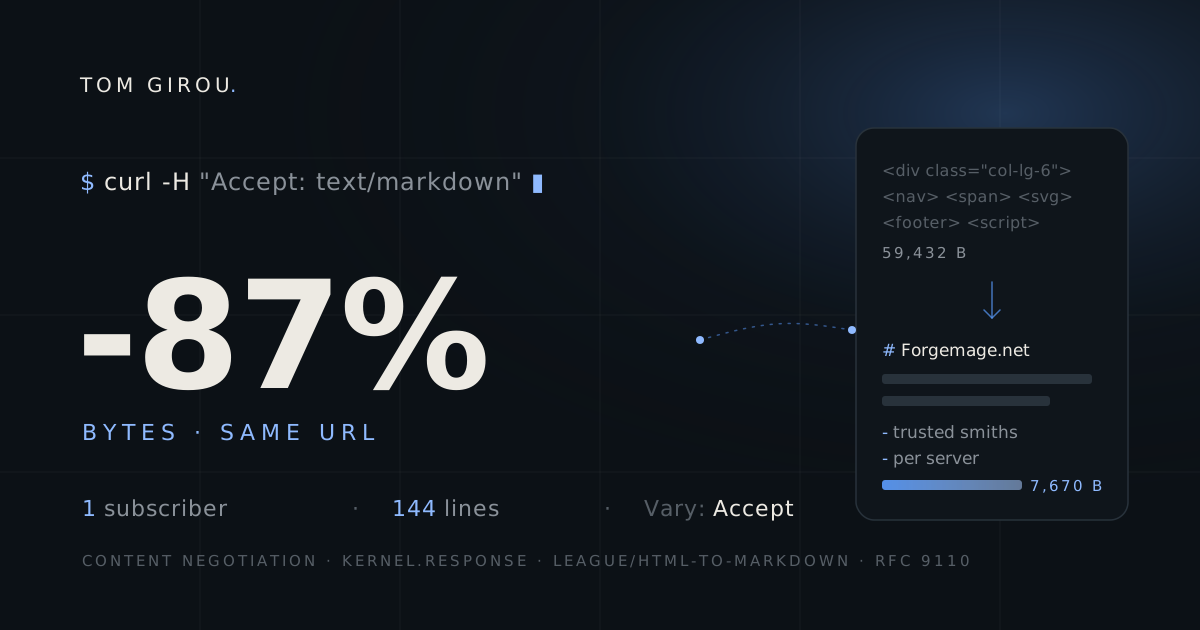
Uma fatia crescente do tráfego do meu side project não é gente. Forgemage.net é um marketplace onde jogadores de Dofus encontram forjamagos, e desde que a busca assistida por IA decolou, parte dos “visitantes” são LLMs buscando uma página para responder à pergunta de alguém. Eles recebem o mesmo que os navegadores: 59 KB de HTML para mais ou menos mil palavras de conteúdo de verdade. O resto são classes do Bootstrap, ícones SVG, um banner de cookies e um footer que o agente vai tokenizar e ignorar, obedientemente.
Em fevereiro, a Cloudflare lançou uma feature chamada Markdown for Agents: quando um cliente envia Accept: text/markdown, o edge deles converte a resposta HTML em markdown na hora. Eles falam em cerca de 80% menos tokens por página. É um toggle no dashboard — a partir do plano Pro.
A questão é que não tem mágica da Cloudflare nesse contrato. É negociação de conteúdo HTTP, um mecanismo mais antigo que a maioria dos problemas da web, mais um conversor de HTML para markdown. Forgemage.net é uma app Symfony, então implementei o mesmo comportamento eu mesmo: um event subscriber, um pacote composer, uma tarde de trabalho incluindo os testes. Este post mostra a implementação e os três detalhes que teriam me mordido em produção se a RFC não tivesse me avisado antes.
O contrato antes do código
Como servir HTML e markdown na mesma URL? As duas versões vivem na mesma URL. Um navegador que pede https://forgemage.net/ recebe HTML; um agente que envia Accept: text/markdown recebe markdown. Nada de prefixo /md/, nada de sufixo .md, nenhuma rota separada para manter.
Essa é a parte agradável. As regras de negociação são onde as implementações dão errado sem fazer barulho:
O markdown tem que ser pedido pelo nome. O header Accept de todo navegador termina com */*;q=0.8, e um wildcard tecnicamente casa com text/markdown. Trate o wildcard como opt-in e você vai servir markdown para o Chrome. Tomo cuidado com essa desde que li o header que o Firefox realmente envia.
q=0 é uma recusa explícita, não uma preferência baixa — a RFC 9110 diz que uma qualidade zero significa “nunca me mande isso”. Um cliente que diz text/markdown;q=0 recebe HTML, ponto final.
Empate vai para o markdown. Se um cliente lista text/html e text/markdown com a mesma qualidade, ele nomeou o markdown explicitamente. Navegadores nunca fazem isso. Uma máquina que se deu ao trabalho de escrever text/markdown no header Accept quer markdown.
Aqui está essa lógica no subscriber, usando o parser AcceptHeader do Symfony para eu não ter que implementar na mão a ordenação por qualidade:
private function prefersMarkdown(Request $request): bool
{
    $accept = AcceptHeader::fromString($request->headers->get('Accept'));

    // Markdown must be asked for by name (case-insensitively, with any
    // media parameters) — a wildcard match is not opt-in.
    $markdown = null;
    foreach ($accept->all() as $item) {
        if (strcasecmp($item->getValue(), 'text/markdown') === 0) {
            $markdown = $item;
            break;
        }
    }

    // q=0 is an explicit refusal per RFC 9110.
    if ($markdown === null || $markdown->getQuality() <= 0.0) {
        return false;
    }

    $html = $accept->get('text/html');

    return $html === null || $markdown->getQuality() >= $html->getQuality();
}
O loop manual no lugar de $accept->get('text/markdown') é proposital: ele tolera variação de maiúsculas (Text/Markdown) e parâmetros de mídia (text/markdown;variant=GFM), ambos válidos pela RFC e ambos coisas que um lookup estrito de string deixaria passar.
Onde plugar, e o que proteger
Onde a conversão deve morar, e o que precisa ser protegido? A feature inteira é um subscriber de kernel.response. O controller renderiza HTML exatamente como antes; o subscriber decide depois se troca o body. Nenhuma mudança no controller, nenhuma mudança no template, e apagar a classe remove a feature de forma limpa.
Antes de converter qualquer coisa, ele desiste a menos que todas estas condições sejam verdadeiras: é a request principal, o método é GET ou HEAD, a resposta é text/html, o status é 200 e — a proteção que mais me importa — a rota é indexável.
if (!\in_array($request->getMethod(), [Request::METHOD_GET, Request::METHOD_HEAD], true)
    || !$this->sitemapService->isIndexable($request->attributes->get('_route'))
    || !str_starts_with($response->headers->get('Content-Type') ?? 'text/html', 'text/html')
) {
    return;
}
Essa chamada a isIndexable() reaproveita o service que já gera meu sitemap e meu robots.txt. A app tem uma única definição de “página pública”, e a versão markdown a herda. Um agente logado que acessa /wishlist ou uma thread de mensagens com Accept: text/markdown recebe HTML puro, porque essas rotas nunca foram indexáveis. Não precisei enumerar as páginas privadas uma segunda vez, o que significa que também não posso esquecer uma delas uma segunda vez.
Convertendo HTML que nunca foi escrito para virar markdown
O que envolve, na prática, transformar o HTML de uma página em markdown limpo? A conversão em si é o league/html-to-markdown, configurado uma vez e guardado no subscriber:
$this->htmlConverter = new HtmlConverter([
    'strip_tags' => true,
    'strip_placeholder_links' => true,
    'remove_nodes' => 'head script style noscript template iframe canvas svg nav header footer',
]);
$this->htmlConverter->getEnvironment()->addConverter(new TableConverter());
A lista remove_nodes é a decisão editorial escondida na config. Scripts e styles são óbvios. nav, header e footer são uma escolha: um agente que pede a versão markdown quer o conteúdo da página, não quarenta links de navegação e um seletor de idioma repetidos em cada URL do site. Cortar esse chrome é boa parte do motivo de o output encolher tanto. O TableConverter é opt-in no pacote da league, e o Forgemage.net tem tabelas de preço que eu prefiro que os agentes leiam como tabelas, e não como um texto corrido.
Dois pequenos toques depois da conversão. Se o resultado não começa com um heading # , o subscriber promove o <title> do HTML a heading, para que todo documento markdown abra com o seu assunto — a primeira coisa que um agente bate o olho. E a conversão inteira fica dentro de um try/catch (Throwable) que faz fallback para servir o HTML intacto. Uma versão markdown é um nice-to-have; ela não tem o direito de dar 500 numa página pública.
Os três detalhes que realmente importam
Quais detalhes de implementação mordem de verdade em produção? Tudo acima é direto. Estes três são o motivo pelo qual eu indicaria este post a um colega em vez de só o README do pacote.
Vary: Accept, nas duas versões. Dois bodies diferentes vivem numa mesma URL, então todo cache entre o agente e a app precisa usar o header Accept na chave. Esqueça isso e um CDN vai alegremente cachear a versão markdown e servi-la para o próximo navegador. O subscriber define esse header antes de checar se o markdown foi sequer pedido, e antes da checagem do 200, porque a URL negocia independentemente do que essa resposta em particular acabou sendo. O setVary('Accept', false) do Symfony adiciona em vez de substituir, então um Vary existente vindo de outro listener sobrevive.
HEAD precisa negociar como GET. Um agente pode fazer HEAD numa URL primeiro para checar o Content-Type antes de se comprometer com o download. O próprio ResponseListener do Symfony (prioridade 0) remove o body das respostas HEAD durante o prepare(), então este subscriber se registra com prioridade 10 para rodar antes — a resposta HEAD traz Content-Type: text/markdown e Vary: Accept exatamente como sua gêmea GET, só que sem body.
Recalcule o que a troca de body invalida. Depois de substituir o conteúdo, o header Content-Length desatualizado tem que sair (o Symfony o recalcula), e o Content-Type vira text/markdown; charset=utf-8. Para a versão HTML, o subscriber adiciona em vez disso uma dica de descoberta: Link: <same-url>; rel="alternate"; type="text/markdown", que é como um crawler fica sabendo que o markdown existe sem que alguém precise contar por fora.
Provando que funciona
Como provar que a negociação funciona? Sete testes WebTestCase fixam a matriz de negociação: Accept de navegador mantém HTML, */* não é opt-in, q=0 recusa, Text/Markdown;variant=GFM casa, HEAD traz os mesmos headers, e uma request logada numa rota privada nunca é convertida. A suíte inteira é chata de propósito — cada teste são quatro linhas de “envia este header Accept, verifica este Content-Type”.
Contra produção:
$ curl -sI https://forgemage.net/ | grep -i -e vary -e "text/markdown"
link: <https://forgemage.net/>; rel="alternate"; type="text/markdown"
vary: Accept

$ curl -s -H "Accept: text/markdown" https://forgemage.net/ | head -2
# Trouve tes forgemages sur notre plateforme Forgemage.net

$ curl -so /dev/null -w "%{size_download}\n" https://forgemage.net/
59432
$ curl -so /dev/null -w "%{size_download}\n" -H "Accept: text/markdown" https://forgemage.net/
7670
De 59.432 bytes para 7.670 — uma redução de 87% no tráfego, em linha com os ~80% de tokens da Cloudflare. A versão markdown é a página que um humano descreveria se você perguntasse o que tem nela.
Os limites, sendo honesto
Quando servir markdown desse jeito deixa a desejar?
Lixo entra, lixo sai. O conversor transforma o HTML renderizado; ele não consegue adicionar estrutura que seus templates não têm. Os templates Twig do Forgemage.net usam headings de verdade e listas semânticas, então o markdown sai legível. Um front-end que é uma sopa de divs produziria uma sopa de markdown.
Quase ninguém pede ainda. Não vi nenhum crawler mainstream enviar Accept: text/markdown espontaneamente. Os agentes de hoje em geral buscam HTML e convertem do lado do cliente — a própria ferramenta WebFetch do Claude Code faz exatamente isso. Esta feature é uma aposta de que a convenção que a Cloudflare está empurrando vire padrão, e o que está em jogo é pouco: uma dependência, 144 linhas, nenhum custo recorrente. Servir a conversão a partir da origem também significa que o conversor do próprio agente nunca vê meu banner de cookies.
Complementa o llms.txt, não o substitui. Este próprio site tem um /llms.txt — um mapa curado para agentes. A negociação de conteúdo responde a outra pergunta: “me dá esta página, barato”. Um é o sumário, o outro é o livro impresso numa fonte legível.
Lições
O que vale levar para a sua própria stack?
- O Markdown for Agents da Cloudflare é um contrato, não um produto.
Accept: text/markdownna entrada, body convertido maisVary: Acceptna saída. Qualquer framework com eventos de resposta consegue honrá-lo. - Os edge cases da negociação são a feature. Wildcard não é opt-in,
q=0significa nunca, o matching é case-insensitive e tolera parâmetros. Erre isso e os navegadores veem markdown. - Reaproveite sua lógica de indexabilidade como trilho de segurança. Se o sitemap não listaria, a versão markdown não deveria existir. Uma única definição de “público”, aplicada duas vezes de graça.
- Remova o chrome na config do conversor. Tirar
nav,headerefooteré de onde vem a maior parte dos 87%, e é uma única string de config.
Uma tarde de trabalho, a maior parte escrevendo testes para headers Accept que espero que nenhum cliente jamais envie. Mas quando o primeiro agente pedir markdown pelo nome ao meu servidor, ele vai receber uma resposta limpa com 87% de desconto — e eu não precisei mudar de plano para isso.